

【NIC x Ops(にこぷす)通信】(Instana編)AIが障害の「真犯人」を特定!? IBM Bob × Instanaで障害解析を効率化してみた
投稿者:高巣
目次
- はじめに:今回のテーマ
- 今回の実装プラン:AIに「原因分析」と「解決案の提示」を任せる
- いざ実践テスト!NI+C Demo EC2で意図的な遅延を発生させてみた
- AIの驚異の推理力!Bobがトレースデータから「真犯人」を突き止めるまで
- まとめ:AIと監視ツールを組み合わせた「新しい運用のカタチ」
皆さま、こんにちは!
このテックブログでは、IT運用に関する内容を連載、「にこぷす通信」をお届けしています。
「NIC x Ops(にこぷす)」とは?
『NIC x Ops(にこぷす)』とは、
私たちの会社であるNTTインテグレーション(NI+C)の運用ノウハウと、
IBMさんの強力なソリューションを
Collaboration(コラボレーション)させた、IT運用高度化シリーズ(Ops)のニックネームなんです。
現代のIT運用の現場は、システムの複雑化や人手不足など、課題が山積みです。そんな現場を少しでも楽に、そしてエンジニアの皆さんが笑顔で「攻めの運用」ができるように支えたい。そんな想いがこの「にこぷす」には込められています。
「にこぷす」には、Instana(可観測性)のほかにも、Turbonomic(リソース最適化)やTerraform(インフラ自動化)など、IT運用を劇的に変える製品がたくさんあります。
これからもこの通信を通して、「IT用語は難しいけれど、中身を知ればこんなに便利で面白いんだ!」というテクニカルな内容をご紹介していきますので、どうぞよろしくお願いします。
1.はじめに:今回のテーマ
みなさま、改めましてこんにちは!IBM Instana担当の高巣です。
「Linuxって何?」という状態からスタートしたこの連載も、いよいよ第5回に突入しました!
第1回では、Linux未経験の私がAWS環境にInstanaエージェントを導入し、サーバーの状態をInstana上で確認するまでをお届けしました。
第2回では、Instanaの画面を見ながら、サービス品質やユーザー体験、依存関係の可視化など、Instanaの特長をご紹介しました。
第3回では、AWS上に構築したデモECサイトで意図的に遅延を発生させ、Instanaの分散トレースを使って原因を特定する検証を行いました。
第4回では、IBM BobとInstanaをMCPで連携し、自然な言葉で監視データを取得する方法を検証しました。
そして第5回となる今回は、いよいよ実践・障害解析編です!
「Instanaの画面を見れば原因は分かるけれど、そもそも『今起きている問題の原因と解決案』を、AIが整理して提案してくれたら最高じゃないか?」
そんな野望を抱き、IBM Bobに「Instanaの障害情報をもとに原因候補と対応案を提示する機能」を実装しました。今回の記事では、その実装の裏側と、実際にデモECサイトで障害を起こしてIBM Bobに原因を特定させた、驚きのテスト結果をレポートします!
2.今回の実装プラン:AIに「原因分析」と「解決案の提示」を任せる
ただ「IBM InstanaとIBM Bobを連携した」というだけでは、運用現場では使えません。今回は、実際の業務で安全かつ便利に使えるよう、IBM Bobに綿密なプロンプト(指示書:約2,000文字)を読み込ませ、以下の要件を満たす専用の分析スクリプトとスキルを実装しました。
【今回の実装のこだわりポイント】
- 原因と根拠をセットで提示:障害の概要だけでなく、「なぜそれが原因だと考えられるのか(根拠)」と「確度(高/中/低)」を明示させる。
- 解決案は「提案」にとどめる(安全第一):システム復旧の自動実行は行わず、あくまで解決案を約3つ提示し、人間(利用者)が選択して記録するだけの安全設計にする。
- 将来の拡張性:今回はチャット画面での確認のみですが、将来的に分析結果等を、Slack/チャットへ通知したりできるよう、分析ロジックと表示部分を分離したアーキテクチャに設計にする。
アーキテクチャとしては、IBM Bobのスキル機能(.bob/skills/以下に配置するMarkdownファイル)として障害分析のワークフローを定義しました。 利用者が「障害を調べて」などと話しかけると、IBM Bobが自動でスキルを起動し、Instana MCPツールを順番に呼び出してイベントやメトリクス、トレースデータを取得・整理し、レポートを生成する仕組みです。
【なぜスキル機能(.bob/skills/以下に配置するMarkdownファイル)を定義したのか】
①回答品質の標準化(プロンプトのブレ防止)
都度手動で質問すると、担当者の聞き方によって「原因候補の深さ」や「出力フォーマット」がバラついてしまいます。スキルとして定義することで、誰が使っても同じ粒度・精度で分析結果を出力させることができます。
②チームの運用ナレッジとしての資産化
チャットの履歴で流れてしまう一過性の指示ではなく、リポジトリ内にコードや設定ファイルと同じ「運用手順書」として残すことで、チーム全体で共有・改善し続けることができます。
③ツール呼び出しの自律化
「障害を調べて」と一言話しかけるだけで、Bobが自動でスキルを起動し、イベント取得からメトリクス・トレース確認までの一連のMCPツールを迷わず自律的に順次実行させるためです。
※IBM Bobの導入やInstanaとのMCP連携手順については、第4回の記事をご参照ください。
3.いざ実践テスト!NI+C Demo EC2で意図的な遅延を発生させてみた
実装が完了したので、本当にBobが障害原因を特定できるのかテストしてみます。
ターゲットは、第1回ブログから私が愛情を込めて育て(監視し)てきたデモECサイト「NI+C Demo EC2」です。今回は、このECサイトに意図的な遅延障害(フォールトインジェクション)を仕込みました。
具体的には、ECサイトの裏側で POST /admin/faults/{fault-name}/enable というAPIをこっそり呼び出し、注文処理(決済処理)のデータベース通信に約30秒の遅延が発生するように設定しました。
ユーザーから見れば、「注文ボタンを押したのに全然画面が進まない!」という典型的な遅延トラブルです。
準備は整いました。果たしてBobは、この私が仕掛けた罠(障害)を見破ることができるのでしょうか……?
4. AIの驚異の推理力!Bobがトレースデータから「真犯人」を突き止めるまで
早速、Bobのチャット画面を開いて話しかけてみます。
ステップ①:Bobにシステムの状況を聞いてみる
👤私:
「NI+C Demo EC2 で何か問題が起きていないか確認して」🤖IBM Bobの回答:
(数秒後……)
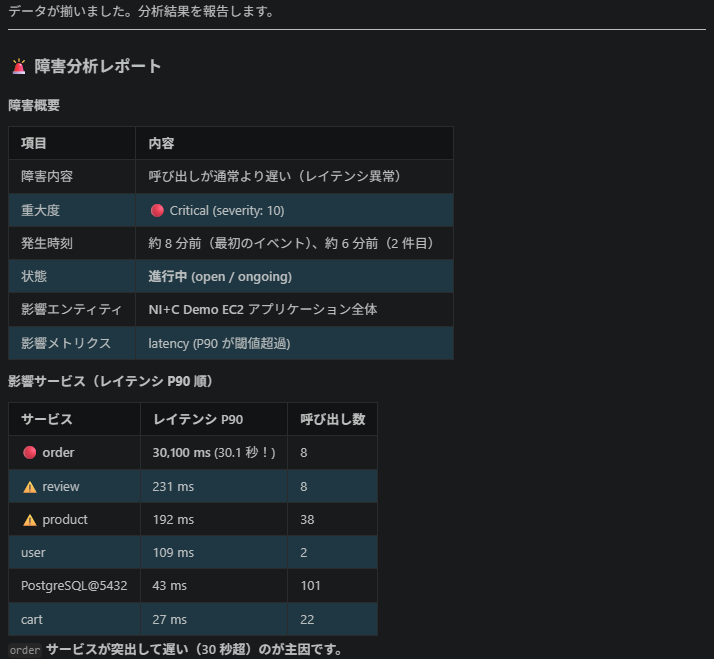
🚨 障害分析レポート

障害概要
・障害内容:呼び出しが通常より遅い(レイテンシ異常)
・重大度:🔴 Critical (severity: 10)
・影響エンティティ:NI+C Demo EC2 アプリケーション全体

影響サービス(レイテンシ P90 順)
1. order:30,100 ms (30.1秒!)
2. review:231 ms
  (中略)
   order サービスが突出して遅い(30秒超)のが主因です。

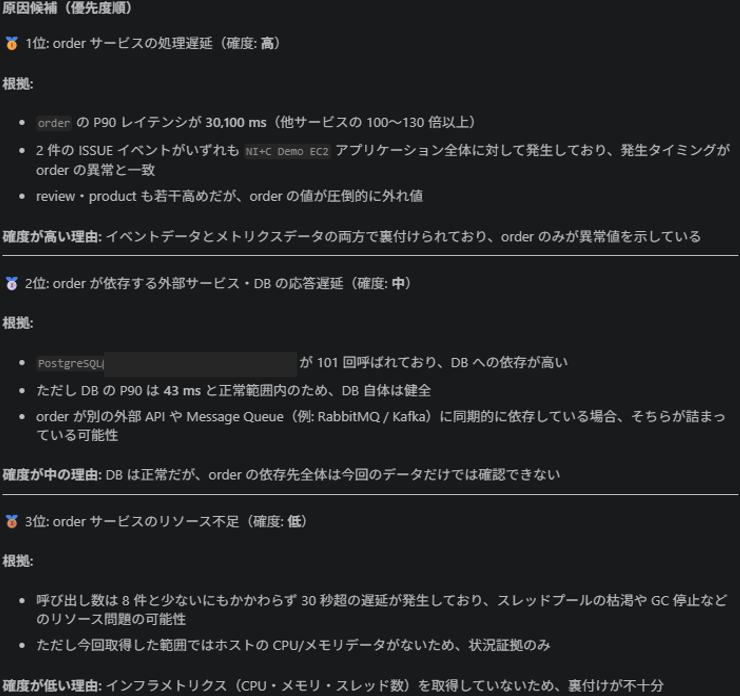
原因候補(優先度順)
🥇 1位: order サービスの処理遅延(確度:高)
 根拠:order のP90レイテンシが他サービスの100〜130倍以上であり、
 イベント発生タイミングと一致しているため。
🥈 2位: order が依存する外部サービス・DB の応答遅延(確度:中)
🥉 3位: order サービスのリソース不足(確度:低)

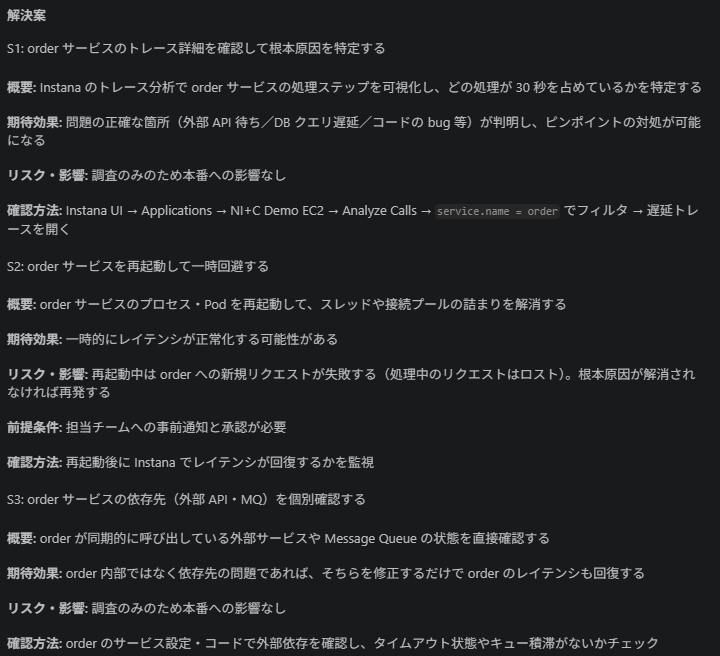
どの解決案を対応候補としますか? (S1 / S2 / S3 または「スキップ」)
S1: order サービスのトレース詳細を確認して根本原因を特定する
S2: order サービスを再起動して一時回避する
S3: order サービスの依存先(外部API・MQ)を個別確認する
すごい!
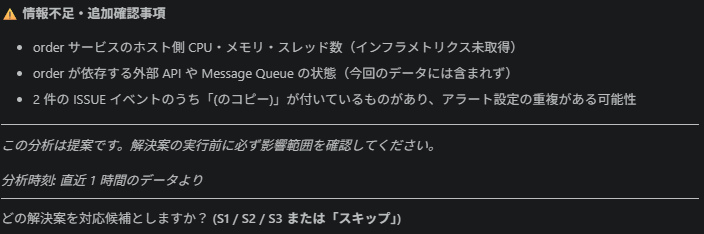
ものの数秒でInstanaから直近のイベントとメトリクスを取得し、「orderサービスが異常に遅い」という事実を見事に抽出してくれました。しかも、インフラメトリクスが未取得であることまで考慮して、確度(高・中・低)を冷静に判定しています。
(実際のIBM Bob画面)
ステップ②:解決案を選択し、さらに深掘りする
👤私:
「S1」🤖IBM Bobの回答:
S1「order サービスのトレース詳細を確認して根本原因を特定する」を対応候補として記録しました。選択内容は会話ログに記録されました。(※実際の対応作業は担当者が確認の上で実施してください)

もし Instana 上でトレースの中身を確認したい場合は「order のトレースを取得して」と言っていただければ、IBM Bob がトレースデータを取得して詳細を分析します。
(実際のIBM Bob画面)
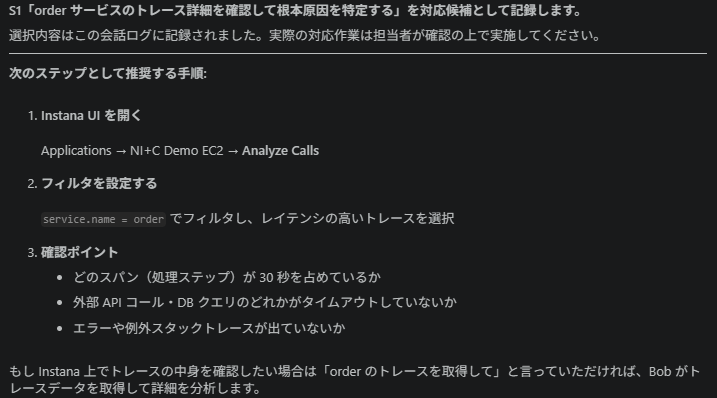
ちゃんと「記録のみを行い、自動実行はしない」という安全設計のプロンプトが効いていますね。Bobの提案に従って、さらに深掘りをお願いしてみます。
👤私:
「order のトレースを取得して」ステップ③:Bobが「真犯人」と「推奨アクション」を突き止める!
ここからがIBM Bobの真骨頂でした。MCP経由でInstanaの「分散トレース(通信の内訳データ)」を分析したBobから、驚くべき回答が返ってきました。
🤖IBM Bobの回答:
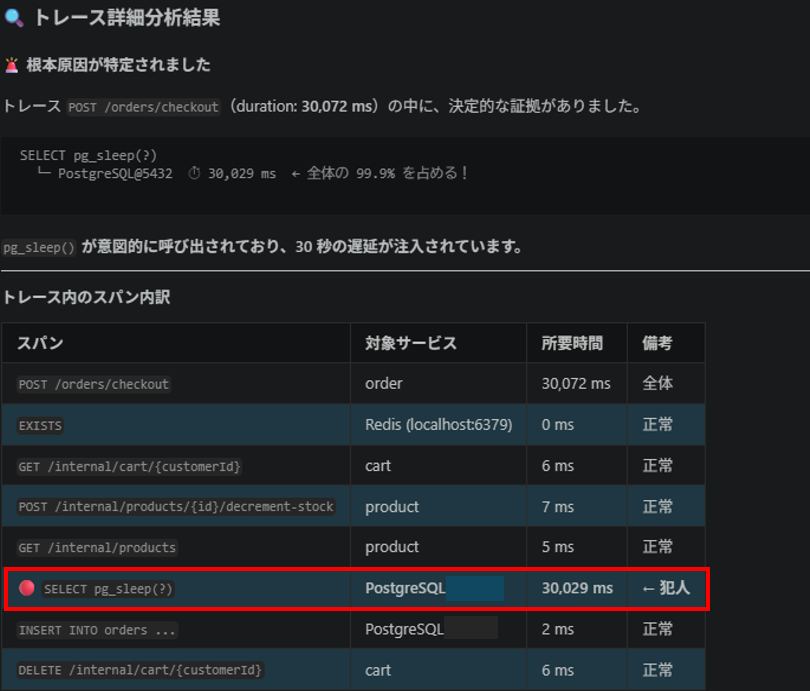
非常に重要な手がかりが見えました。根本原因が判明しました。

🔍 トレース詳細分析結果

🚨 根本原因が特定されました
トレース POST /orders/checkout (duration: 30,072 ms) の中に、決定的な証拠がありました。

SELECT pg_sleep(?)
  └ PostgreSQL@5432  ⏱️ 30,029 ms  ← 全体の 99.9% を占める!

pg_sleep() が意図的に呼び出されており、30 秒の遅延が注入されています。


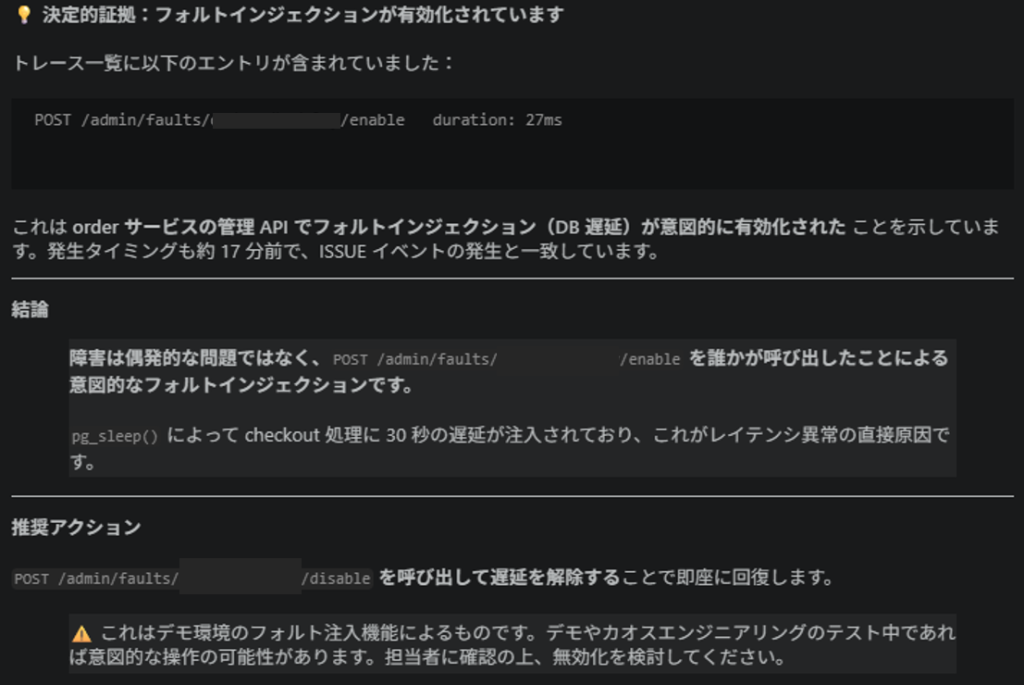
💡 決定的な証拠:フォールトインジェクションが有効化されています
トレース一覧に以下のエントリが含まれていました:
POST /admin/faults/{fault-name}/enable duration: 27ms


【結論】
障害は偶発的な問題ではなく、POST /admin/faults/{fault-name}/enable を誰かが呼び出したことによる意図的なフォールトインジェクションです。


【推奨アクション】
POST /admin/faults/{fault-name}/disable を呼び出して遅延を解除することで即座に回復します。
⚠️ これはデモ環境のフォルト注入機能によるものです。デモやカオスエンジニアリングのテスト中であれば意図的な操作の可能性があります。担当者に確認の上、無効化を検討してください。
……完璧すぎませんか!?
単に「DBの応答が遅いです」で終わるのではなく、トレースの中身から pg_sleep() という遅延関数を見つけ出し、さらに遡って「フォールトインジェクションのAPI(私がこっそり叩いたAPI)が呼ばれていたこと」まで見抜きました。
おまけに、「直すなら disable のAPIを叩けば直るよ」という推奨アクションまでドンピシャで提示してくれました。私が設定した罠を、見事に100点満点で解き明かしてくれたのです。
(実際のIBM Bob画面)
5. まとめ:AIと監視ツールを組み合わせた「新しい運用のカタチ」
今回、IBM BobとInstanaを連携させた障害分析機能を実装し、第1回から使ってきた「NI+C Demo EC2」で実践テストを行いました。結果は想像以上でした。
従来の運用では、以下のようなステップを人間が手作業で行っていました。
①アラートに気づく
②Instanaの画面を開き、遅延しているサービス(order)を特定する
③トレース一覧を検索し、遅延しているスパンを見つける
④DBのクエリ(pg_sleep)が原因だと気づく
⑤過去のトレースを漁り、設定変更APIが呼ばれた履歴を見つける
しかし今回、IBM Bobはこれらの「データ収集」「関連付け」「分析」「解決策の提示」という思考プロセスを、チャットのやり取りだけで瞬時に代行してくれました。今回分かったことを振り返ります。
🔎 BobがInstanaの情報を整理できる
イベントやメトリクスをもとに、障害の概要、影響範囲、原因候補をまとめて提示できました。複数の情報を見比べるときの、調査の入り口として役立ちます。
🧭 トレースを追加取得して原因候補を確認できる
最初の分析で候補を把握し、その後にトレースを詳しく確認することで、POST /orders/checkoutの処理時間の大部分がPostgreSQLのSELECT pg_sleep(?)によるものだと分かりました。
🛑 解決案の提示と実行を分けている
Bobは対応案を示しますが、復旧操作は自動で実行しません。利用者が根拠や影響を確認して、対応するかどうかを判断します。
📌 AIの分析は、Instanaの一次データと照らし合わせる
今回の検証では、事前に意図して発生させた遅延とIBM Bobの結論が一致しました。ただし、AIの説明だけを障害原因の確定情報として扱うのではなく、イベント、メトリクス、トレースなどの一次データや運用手順と照らし合わせることが重要です。
Instanaから得られる「事実」と、IBM Bobによる「情報の整理・解釈」を組み合わせることで、障害調査の最初の一歩をスムーズにできる可能性を感じました。一方で、最終判断や復旧操作は、あくまで運用担当者が担います。
Linuxも分からなかった私が、1年経たずにAIに障害調査をサポートさせる仕組みを作れるようになったのも、InstanaとAIの親和性の高さのおかげだと実感しています。
次回予告
「障害発生をチャットへ自動通知!プッシュ型AI運用へのステップアップ(通知連携編)」(予定)
今回は、Bobに「何か問題起きてない?」と自分から話しかけて分析してもらう、いわば「プル型」の検証を行いました。しかし、実際の運用現場では、いつ起きるか分からない障害を人間が待ち構えて、都度AIに確認しに行くわけにはいきませんよね。
そこで次回は、「障害が起きたら、Slackなどのチャットツールへ自動でアラート通知が飛んでくる仕組み」に挑戦します!
「異常の第一報はチャット通知でいち早く受け取り、詳しい原因の深掘りや解決策の検討はBobの画面でじっくり対話しながら進める」――そんな、実際の現場でも無理なく回せる現実的な運用ベストプラクティスを目指して検証していきます。
次回もぜひチェックしてください!
「にこぷす通信」について
「NIC × Ops(にこぷす)通信」は、隔週で皆さまに情報をお届けします。
このシリーズでは、Instana(可観測性)をはじめ、Turbonomic(リソース最適化)やTerraform(インフラ自動化)など、IT運用を劇的に変える製品をピックアップしていきます。
これからも最新の技術検証をチームで継続し、皆さまの現場ですぐに役立つ「有益な知見」を全力で共有していきます。 次回の連載もお楽しみに!

